"분류만 하면 되는데 왜 3초를 기다리고, 문장 하나를 파싱하고, 실패하면 재시도까지 해야 하지?" — 지원 티켓을 부서별로 나누는 코드를 짜 본 분이라면 한 번쯤 든 생각일 겁니다. 2026년 9월 15일, 이 질문에 정면으로 답하겠다는 모델이 나왔습니다. TypeSafe AI 의 Jev(제브) 입니다. 글을 한 글자도 쓰지 않고, 결정과 그 확률만 돌려주는 모델입니다.
이 글은 LLM 과 Jev 를 대결시키는 글이 아닙니다. 두 모델은 서로 다른 계약(contract)을 가진 서로 다른 원시 요소(primitive)이고, 실제로 잘 만든 시스템은 둘을 층으로 쌓습니다. 다만 그 층을 올바르게 나누려면 무엇이 정확히 다른지를 알아야 합니다. 그래서 다섯 개의 축 — ① 출력 계약, ② 생성 원리, ③ 훈련 목표, ④ 비용·지연 구조, ⑤ 아키텍처에서의 자리 — 로 나눠 비교하고, 마지막에 도입 절차를 제안합니다.
초록(Abstract) — LLM 은 토큰을 순차 생성해 문자열을 만들며, 구조화 출력은 그 위에 얹은 제약과 검증입니다. Jev 는 미리 정의된 선택지에 대해 모든 답을 병렬로 샘플링하고, RLCD 로 확률이 실제 결과와 맞도록 훈련됐습니다. 그 결과 스키마 오류가 구조적으로 사라지고 비용은 입력 토큰에만 붙습니다(공식: 입력 $0.042/1M, 출력 무료, 70~500ms). 대가는 생성 능력의 완전한 포기입니다. 우리는 이를 '대체'가 아니라 결정 계층의 분리로 읽어야 하며, Jev → 코드 → 특화 LLM → 사람으로 이어지는 캐스케이드가 그 실천 형태임을 보입니다.
조사·작성 기준: 2026-09-26. TypeSafe AI 공식 블로그·문서, madewithjev.com, systemonemodels.org, dev.to·flaviocopes.com 의 기술 해설, APIMaster 의 API 노트를 참고했습니다. 비교 수치는 전부 TypeSafe 자체 측정이며 독립 재현은 아직 없습니다. 조기 접근 단계라 가격·제한은 바뀔 수 있습니다.
아닙니다. Jev 는 글·코드·요약을 전혀 생성하지 않습니다. 분류·라우팅·점수·예/아니오 판단만 맡고, 생성이 필요한 단계는 LLM 이 담당하는 분업 구조가 공식 문서와 커뮤니티의 공통 결론입니다.
LLM 의 구조화 출력(JSON 모드)과 무엇이 다른가요?⌄
LLM 은 JSON 도 토큰 하나씩 생성하며 스키마는 사후 검증됩니다. Jev 는 선택지가 미리 정의돼 있어 스키마 밖 값이 구조적으로 나올 수 없고, 답과 함께 캘리브레이션된 확률 분포가 옵니다. 대신 자유 텍스트를 만들 수 없습니다.
'환각이 없다'는 주장은 사실인가요?⌄
정확히는 스키마 밖 값을 반환할 수 없다는 뜻입니다. 정의한 선택지 안에서 틀린 답을 고를 수는 있습니다. 형식 오류와 판단 오류를 분리해 생각해야 하며, 신뢰도 임계값은 자기 데이터로 검증해야 합니다.
가격과 속도는 어느 정도인가요?⌄
공식 발표 기준 입력 100만 토큰당 $0.042, 출력 토큰 무료, 엔드투엔드 지연 70~500ms 입니다. 비교 벤치마크는 TypeSafe 자체 측정이라 독립 재현이 아직 없습니다.
어디서부터 도입하면 좋나요?⌄
이미 코드나 LLM 이 하고 있으면서 틀려도 값싼 결정 하나(티켓 분류·스팸 플래그·RAG 관련성 필터)를 고르고, 기존 라벨로 임계값을 검증한 뒤 그 결정만 교체하는 것이 권장 경로입니다.
사진 1. 프로덕션 코드 안의 AI 호출은 대부분 '어느 갈래로 보낼까'를 정하는 결정이다 (연출 사진).
1. 문제 제기 — 소프트웨어가 AI 에게 시키는 일의 대부분은 '결정'이다
챗봇 시대의 AI 는 사람에게 말을 걸었습니다. 그런데 프로덕션 코드 안에서 모델을 부르는 자리를 세어 보면, 사람이 읽을 문장을 요구하는 호출은 소수입니다. 대부분은 이런 질문입니다.
이 티켓은 어느 팀 것인가?
이 댓글은 정책 위반인가?
이 문단은 질문과 관련이 있는가?
이 에이전트의 다음 행동은 클릭·입력·완료 중 무엇인가?
이 LLM 답변은 안전한가?
전부 답의 형태가 미리 정해진 질문입니다. 그런데 우리는 이 질문들을 문장 생성 모델에 던지고, 돌아온 문자열을 파싱하고, 스키마를 검증하고, 실패하면 재시도하고, 그래도 불안하면 사람을 붙입니다. TypeSafe 창업자 Diogo Almeida 는 이를 "인터페이스 문제" 라고 부릅니다. 챗 모델은 문자열을 내놓는데, 소프트웨어는 타입 있는 값을 원한다는 것입니다.
카너먼의 구분을 빌리면, 이 질문들은 System 1(빠르고 직관적인 판단) 에 속합니다. 그런데 우리는 지금까지 System 2(느리고 숙고하는 추론) 를 빌려서 System 1 일을 시켰습니다. TypeSafe 가 자기 모델 부류를 System One 모델이라 이름 붙인 이유가 여기 있습니다. (이름 유래와 출시 배경은 1편 — Jev란 무엇인가에 정리했습니다.)
이 문제 제기가 얼마나 타당한지는 두 가지로 따져 볼 수 있습니다. 첫째, 실제로 결정 호출이 생성 호출보다 많은가 — 에이전트 루프 하나를 뜯어보면 라우팅·검색 판정·가드레일·검증·완료 판정처럼 결정이 다섯이고 생성은 하나인 경우가 흔합니다. 둘째, 결정을 생성 모델로 처리할 때의 비용이 구조적인가 — 다음 절에서 보듯, 자기회귀 생성은 답의 길이와 무관하게 토큰마다 한 번씩 순방향 계산을 하므로 지연과 비용이 구조적으로 붙습니다.
2. 축 ① 출력 계약 — 문자열 vs 타입
두 모델의 가장 근본적인 차이는 API 가 돌려주는 것의 타입입니다.
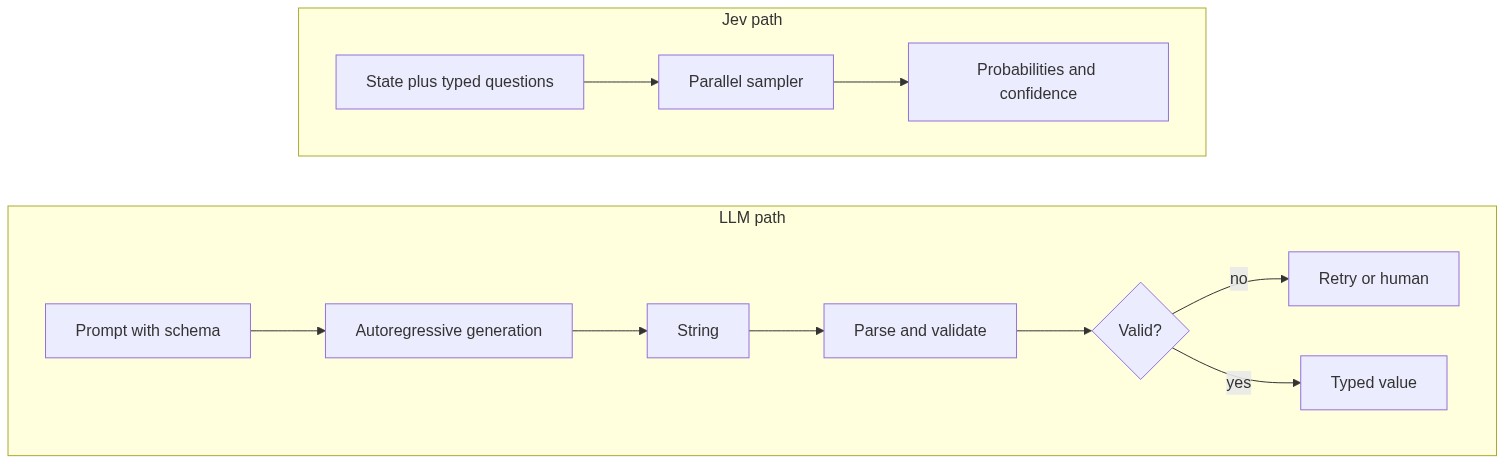
도식 1. 출력 계약 — LLM 은 문자열을 만들고 코드가 파싱·검증·재시도한다. Jev 는 확률과 신뢰도를 바로 돌려준다.
LLM 의 계약은 "문자열을 돌려준다"입니다. 그 문자열이 JSON 일 수도, 마크다운일 수도, 거절 메시지일 수도, 그럴듯한 오답일 수도 있습니다. 구조화 출력(structured output)·JSON 모드·툴 콜링은 이 문자열이 스키마를 따르도록 제약하고 검증하는 층이지, 계약 자체를 바꾸지는 않습니다. 생성이 중간에 끊기거나 유효하지 않은 값이 나오면 SDK 는 '구조화 출력 오류'를 보고합니다.
Jev 의 계약은 "정의한 질문마다 확률 분포와 신뢰도를 돌려준다"입니다. 질문은 세 타입 중 하나이고(5절), 답은 그 타입의 값 공간을 절대 벗어나지 않습니다. 그래서 파서·검증기·재시도 코드가 원리적으로 필요 없습니다. 대신 문장·코드·요약은 어떤 경우에도 나오지 않습니다.
관점
LLM
Jev
반환 타입
문자열 (스키마는 사후 검증)
질문별 확률 분포 + 신뢰도
답의 값 공간
열림 (무한)
닫힘 (내가 정의한 선택지)
형식 오류
가능 (0.58~45.5%, TypeSafe 표)
구조적으로 0
판단 오류
가능
가능 (틀린 '유효한' 답)
불확실성 표현
텍스트로 서술 (비캘리브레이션)
확률 값 (RLCD 로 캘리브레이션)
생성
가능
불가
여기서 한 가지를 분리해 두어야 합니다. Jev 홍보 문구의 "환각 불가(cannot hallucinate)" 는 형식 오류가 0 이라는 뜻이지 판단이 항상 맞다는 뜻이 아닙니다. TypeSafe 자신도 벤치마크 도표의 0% 에 대해 "경험적 수치가 아니라 스키마 일치가 보장되므로 넣은 값"이라고 밝혔습니다. 형식 오류와 판단 오류가 서로 다른 문제로 분리된다는 것이 정확한 표현입니다. 이 구분은 9절 한계에서 다시 중요해집니다.
3. 축 ② 생성 원리 — 자기회귀 vs 병렬 샘플링
계약이 다른 이유는 계산 방식이 다르기 때문입니다.
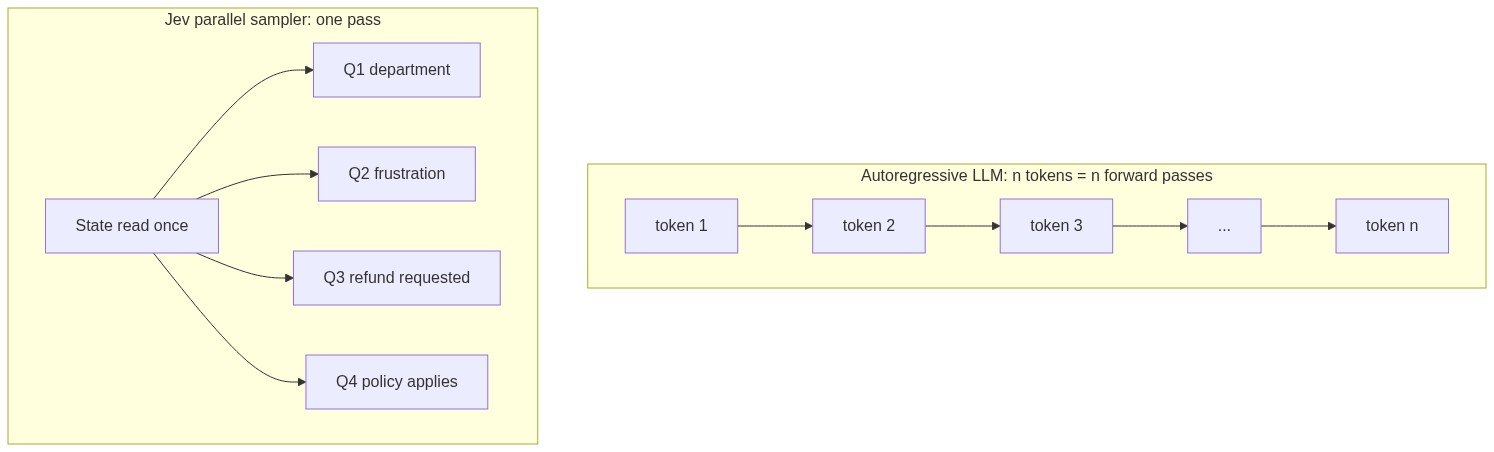
도식 2. 생성 원리 — 자기회귀는 토큰을 순서대로 이어 붙이고, 병렬 샘플러는 state 를 한 번 읽어 모든 질문에 동시에 답한다.
LLM 은 자기회귀(autoregressive) 입니다. {"category": "billing", "urgent": true} 라는 짧은 JSON 을 돌려주려 해도, 모델은 첫 토큰 { 를 예측하고, 그것을 입력에 붙여 다음 토큰을 예측하고… 를 출력이 끝날 때까지 반복합니다. 답이 20 토큰이면 순방향 계산이 20번입니다. 그래서
지연은 출력 길이에 비례하고,
출력 토큰에 비용이 붙으며(대개 입력의 수 배),
생성 도중 스키마를 벗어날 기회가 토큰마다 생깁니다.
Jev 는 병렬 샘플러(parallel sampler) 를 씁니다. 상태(state)를 한 번 읽고, 요청에 담긴 모든 질문의 모든 선택지에 대한 확률을 한 번의 패스로 계산합니다. 토큰을 이어 붙이는 과정이 없으므로
질문이 1개든 60개든 지연이 거의 같고(TypeSafe: "60개 질문이 1개와 비슷한 비용"),
출력 생성 단계가 없어 출력 토큰이 무료일 수 있으며,
선택지 밖의 값은 계산 자체가 정의되지 않아 나올 수 없습니다.
TypeSafe 의 쿡북 실측 하나가 이 성질을 잘 보여 줍니다. 긴 위키피디아 문서에 규제 관련 질문 13개를 던지는 과제에서, 한 호출로 묶었을 때가 하나씩 물을 때보다 12.2배 저렴하고 10배 빨랐으며 답은 동일했습니다. 자기회귀 모델에서는 질문을 묶어도 출력이 길어져 이득이 제한되지만, 병렬 샘플러에서는 state 를 한 번만 읽는 것이 곧 이득입니다.
한계도 같은 원리에서 나옵니다. 열린 답 공간이 필요한 순간 — 요약, 초안, 코드, 이름 추출 — 에는 선택지를 미리 정의할 수 없으므로 병렬 샘플러가 할 일이 없습니다. 이때는 여전히 자기회귀 생성이 필요합니다. 그래서 자유 텍스트에서 값을 뽑아야 하면 "정규식이나 LLM 으로 후보를 먼저 만들고, Jev 가 고르게 하라"는 것이 공식 권고입니다.
4. 축 ③ 훈련 목표 — RLHF vs RLCD, 그리고 캘리브레이션
두 모델은 무엇을 잘하도록 훈련됐는가도 다릅니다.
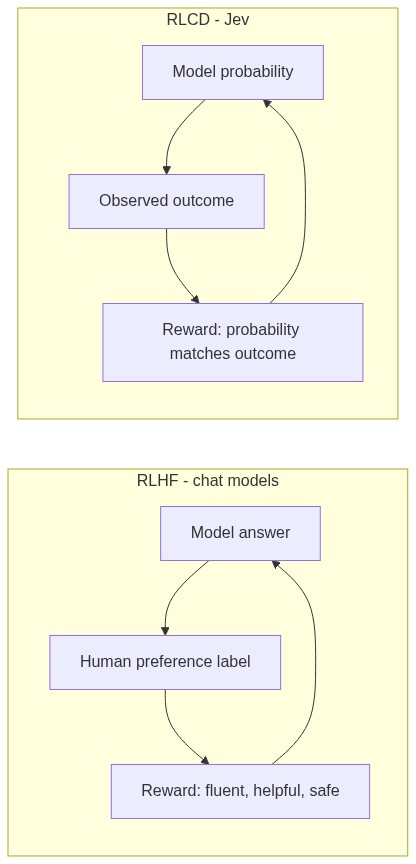
도식 3. 훈련 목표 — RLHF 는 사람이 선호하는 답을, RLCD 는 결과와 맞는 확률을 보상한다 (TypeSafe 설명 기준).
대부분의 챗 모델은 RLHF(사람 피드백 강화학습) 계열로 마무리됩니다. 목표는 사람이 선호하는 답입니다. 유창함·도움됨·안전함이 보상에 들어가고, 그 결과 모델은 "70% 확신합니다" 같은 문장을 만들 수는 있지만, 그 70% 가 실제 정답률과 맞는다는 보장은 없습니다. 확신 표현은 문체로 학습된 것이기 때문입니다.
TypeSafe 는 Jev 를 RLCD(Reinforcement Learning for Calibrated Decisions) 로 훈련했다고 밝힙니다. 목표는 확률이 결과와 맞는 것입니다. 캘리브레이션(calibration)의 정의는 단순합니다 — 모델이 90% 라고 말한 답들을 모아 보면 실제로 약 90% 가 맞아야 합니다. 이것이 왜 중요한지는 시스템 설계자 관점에서 보면 분명합니다.
임계값이 의미를 갖습니다. "신뢰도 0.85 이상만 자동 승인"이라는 규칙이, 집계적으로 약 15% 의 오류를 감수한다는 뜻으로 읽힙니다.
임계값을 행동별로 다르게 둘 수 있습니다. 잔액 조회(읽기 전용)는 낮게, 송금 승인(돈이 움직임)은 높게 — 틀렸을 때의 비용에 맞춰 조정하는 것이 가능해집니다.
낮은 신뢰도가 신호가 됩니다. 확률 분포가 평평하면 모델이 헷갈린 것이 아니라 내 선택지 정의가 서로 구분되지 않는다는 뜻일 때가 많습니다.
단, 캘리브레이션은 집계 성질입니다. 개별 답 하나에 대해서는 아무것도 보장하지 않습니다. 그래서 TypeSafe 문서는 "신뢰도 임계값을 자기 데이터로 시험한 뒤 정하라"고 반복합니다.
항목
RLHF (일반 챗 모델)
RLCD (Jev)
최적화 대상
사람 선호 (유창·도움·안전)
확률과 결과의 일치
불확실성
문장으로 표현, 비캘리브레이션
수치, 집계적으로 캘리브레이션
시스템 설계에 주는 것
읽기 좋은 답
임계값으로 다룰 수 있는 숫자
보장하지 않는 것
정답
개별 답의 정답
한 가지 정직한 각주를 달아 둡니다. RLCD 의 구체적인 알고리즘·데이터·아키텍처는 공개되지 않았습니다. Jev 는 관리형 API 이고 가중치도 비공개입니다. 우리가 확인할 수 있는 것은 인터페이스와 TypeSafe 가 공개한 측정치이며, 캘리브레이션 품질 역시 자기 트래픽으로 재봐야 합니다.
5. Jev 의 인터페이스 — Choice · Score · Noul
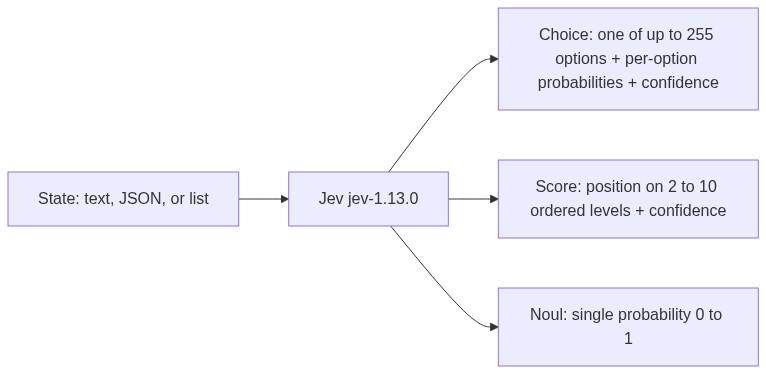
Jev 의 API 는 놀랄 만큼 작습니다. 엔드포인트 하나(POST /v1/systemone), 요청 필드 세 개(model·state·questions), 질문 타입 세 가지. TypeSafe 는 이 작음이 우회할 제약이 아니라 설계라고 말합니다.
도식 4. 인터페이스 — state 하나에 Choice·Score·Noul 을 섞어 보내면 질문별로 타입이 맞는 답이 돌아온다.
state 는 판단 대상입니다. 문자열, JSON 객체, 문자열 배열(대화 로그) 중 하나로, 현재는 텍스트만 받습니다. 이미지·음성은 먼저 캡션·전사해야 합니다. 컨텍스트 한도는 state 와 모든 질문을 합쳐 64k 토큰, state 와 가장 긴 질문 하나를 합쳐 32k 토큰입니다.
questions 는 키를 내가 정하는 맵이고, 응답 answers 도 같은 키로 돌아옵니다. 각 질문은 세 타입 중 하나입니다.
타입
묻는 것
돌려주는 것
제한
Choice
N개 중 하나
choice + 선택지별 probabilities + confidence
선택지 최대 255개
Score
순서 있는 눈금 위 위치
score(소수 가능) + probabilities + confidence
2~10단계
Noul
명제가 참일 확률
noul (0~1 숫자 하나)
별도 confidence 없음
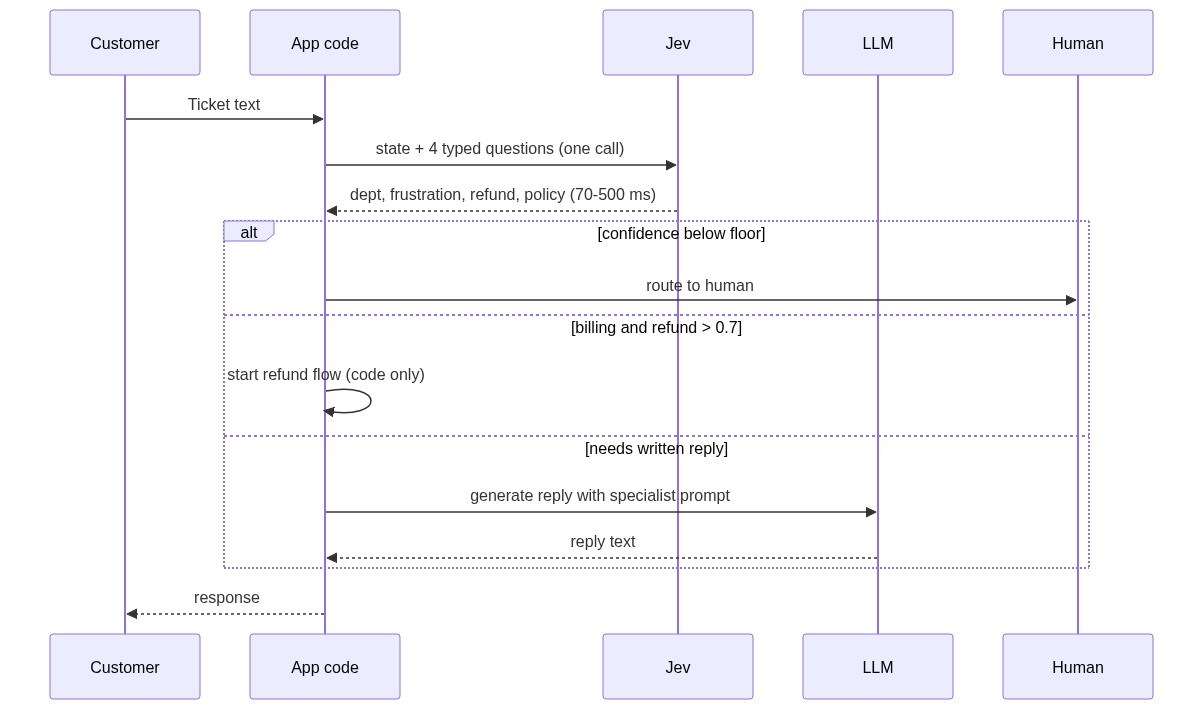
세 타입은 한 요청에 섞어 보낼 수 있고 같은 state 를 놓고 병렬로 평가됩니다. 지원 티켓 하나에 "담당 부서(Choice) · 고객 불만 강도(Score) · 환불을 명시적으로 요구했나(Noul) · 정책이 이 상황을 커버하나(Noul)" 네 질문을 한 번의 왕복으로 묻는 식입니다.
각 타입에는 문서가 강조하는 작성 요령이 있습니다.
Choice 는 선택지가 토큰 몇 개 비용이므로 후보를 줄이지 말고 전체 목록을 넣고, 어느 것도 맞지 않을 때 고를 other 를 반드시 둡니다. 없으면 '가장 가까운 오답'을 고릅니다.
Score 는 단계 번호가 배열 순서이고(0 이 첫 항목), 값은 단계 사이에 떨어질 수 있습니다(예: 1.035). 임계값 판정과 순위에는 좋지만, 1.4 를 "40% 지점"처럼 크기로 읽지는 말라고 문서가 못박습니다. 단계 사이의 수치 캘리브레이션은 약합니다.
Noul 은 명제를 긍정문으로 씁니다. true 가 '아니오'를 뜻하도록 뒤집으면 성능이 떨어집니다.
메타 규칙은 두 줄입니다. 코드가 정확히 계산할 수 있는 것은 묻지 말고, 한 질문에 여러 판단을 숨기지 마라. 이 두 문장이 다음 절의 비용 논리와 9절의 한계를 관통합니다. (타입별 세부와 체크리스트는 2편 — Choice·Score·Noul 참고.)
6. 축 ④ 비용·지연 구조 — 왜 출력이 무료인가
사진 2. 자기회귀 생성은 토큰마다 한 번의 순방향 계산을 쓴다 — 결정 하나에 문장 하나를 생성시키는 비용의 출처 (연출 사진).
Jev 의 가격표는 한 줄입니다. 입력 100만 토큰당 $0.042(10억 토큰당 $42), 출력 무료. 청구는 입력에만 붙습니다. 응답 시간은 엔드투엔드 70~500ms 를 주장합니다. 이 숫자들이 어디서 오는지는 3절의 원리로 설명됩니다 — 출력을 생성하지 않으니 출력 비용이 없고, 병렬 패스 한 번이니 지연이 짧습니다.
6.1 비용 모델을 식으로 놓기
LLM 호출 비용을 단순화하면 입력 토큰 × 입력 단가 + 출력 토큰 × 출력 단가 입니다. 분류 과제에서 출력은 짧지만 출력 단가가 입력의 4~5배라 무시할 수 없고, 프롬프트에 스키마 설명·few-shot 예시가 들어가 입력도 부풀어 오릅니다.
Jev 호출 비용은 (state 토큰 + 질문 토큰) × $0.042/1M 으로 끝납니다. 질문을 하나 더 붙이는 비용은 그 질문의 토큰 수만큼이고, Choice 에 선택지를 더 넣는 비용은 선택지 이름 몇 토큰입니다. TypeSafe 벤치마크의 케이스당 평균은 약 $0.0004 입니다.
6.2 지연 모델
LLM 지연 ≈ 프리필(입력 처리) + 출력 토큰 수 × 토큰당 디코드 시간 + (추론 모델이면) 사고 토큰. TypeSafe 표의 프론티어 모델 3s~329s 라는 넓은 범위는 대부분 사고 토큰에서 옵니다.
Jev 지연 ≈ state 처리 한 번 + 병렬 샘플링 한 번. 질문 수에 거의 무관합니다. 이 성질이 speculative fan-out 이라는 설계 습관을 낳습니다 — "나중에 필요할지 모를 질문을 전부 먼저 던지고 코드가 골라 쓴다." 자기회귀 모델에서는 낭비였던 것이 여기서는 공짜에 가깝습니다.
6.3 규모에서의 차이
TypeSafe 가 제시한 케이스당 수치를 100만 건 지원 티켓에 적용하면 약 $30,400 → 약 $6,480, 그리고 약 80만 건이 10초가 아니라 0.5초 미만에 답을 받습니다. 첫 주 커뮤니티 사례들도 같은 방향을 가리킵니다.
사례 (자체 보고)
구성
보고된 수치
1kpapers.com
논문 1,018편 요약(DeepSeek) → Jev Choice 로 24개 주제 분류
요약 $3.99 · 분류 $0.08 · 편당 256ms
browser-use/jev-ultrafast
페이지를 번호 매긴 요소 표로 → Jev 가 동작+대상 선택
항공권 예약 7.1초 · $0.0039
typesafe-computer-use
OCR 로 화면 읽기 → Jev 가 다음 행동
스텝당 $0.0002 (스크린샷 LLM $0.032 대비)
jev-drone
500Hz 제어·50Hz 안전은 코드, Jev 는 2.5Hz 조언
판단 계층만 담당
6.4 읽을 때의 주의
세 가지를 함께 기억해야 합니다. ① 위 수치는 TypeSafe 와 각 저자의 자체 보고입니다. ② 레이트 리밋은 jev-1.13 기준 초당 250,000 토큰 · 분당 1,200 요청이고 GPU 용량을 늘리는 중이라 예고 없이 바뀝니다. ③ 가격이 보조금인지 TypeSafe 는 증명할 수 없다고 인정하면서도, 내릴 가능성이 더 크다고 말합니다. (가격·벤치마크 세부는 3편 — 속도·가격.)
7. 축 ⑤ 아키텍처 — 함께 쓰는 법, 캐스케이드
여기까지의 비교가 향하는 결론은 하나입니다. Jev 와 LLM 은 경쟁자가 아니라 층입니다. 첫 주에 나온 프로젝트들을 관통하는 원칙도 같았습니다 — 루프·안전·산술은 평범한 코드에, 코드로 표현하기 어려운 좁은 판단은 Jev 에, 생성은 LLM 에.
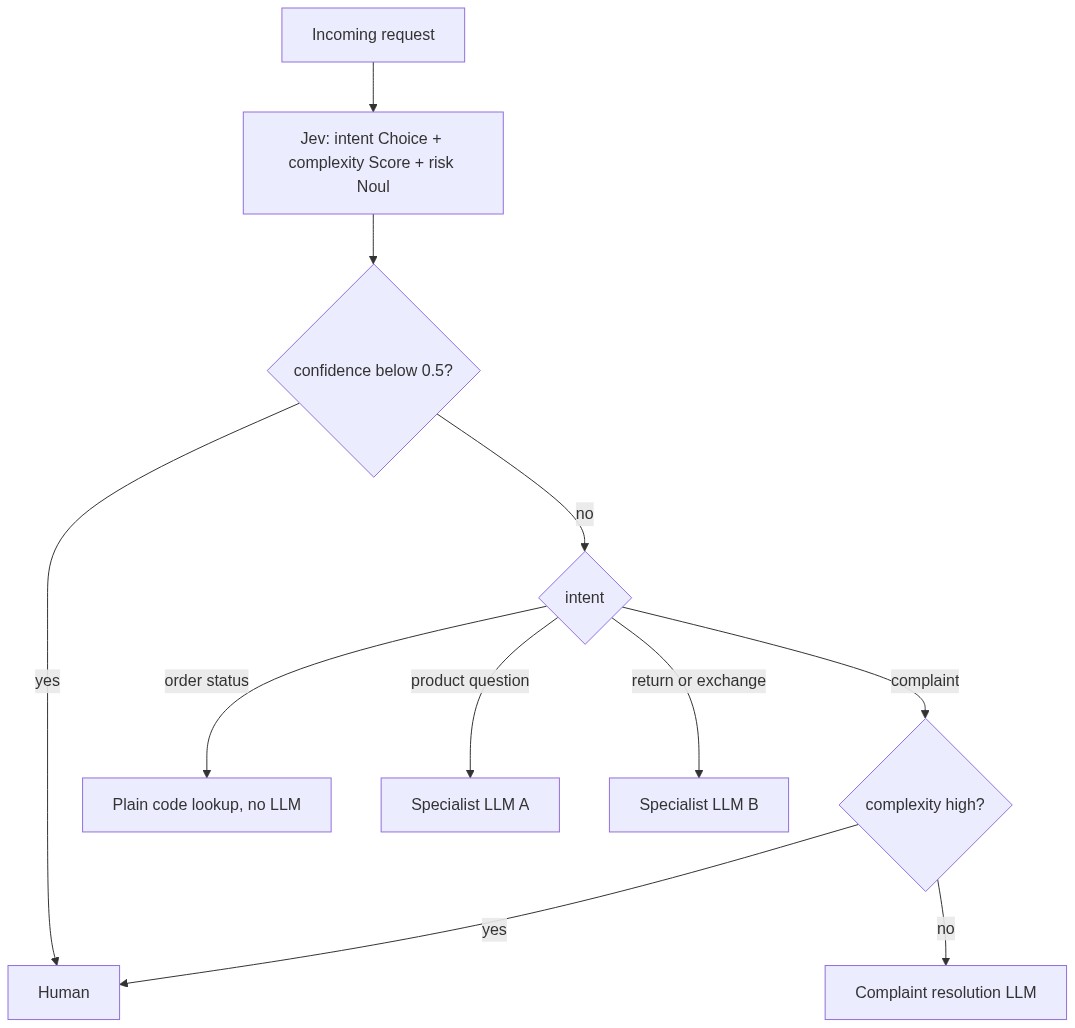
도식 5. 캐스케이드 — Jev 가 한 번 판정하고, 코드·특화 LLM·사람으로 갈린다. 프론티어 모델은 자격이 있는 요청만 받는다.
7.1 캐스케이드의 네 갈래
Jev 가 먼저 판정합니다 — 의도(Choice), 복잡도(Score), 위험 플래그(Noul).
신뢰도가 바닥(예: 0.5) 미만이면 사람에게 보냅니다. 모델이 모르는 것을 모델에게 더 묻지 않습니다.
단순 조회·표준 절차는 모델 없이 코드가 처리합니다. 이 갈래는 LLM 을 한 번도 부르지 않습니다.
생성이 필요한 것은 특화 LLM(제품 문의용·반품용 등 프롬프트가 다른 인스턴스)으로 보내고, 복잡도가 높거나 신뢰도가 애매한 불만은 사람이 받습니다.
한 갈래는 모델을 전혀 쓰지 않고, 두 갈래는 서로 다른 전문가를 부르며, 한 갈래는 에스컬레이션됩니다. 비용 절감의 대부분은 "프론티어 모델을 부를 자격이 있는 요청만 부른다" 에서 나옵니다.
7.2 요청 하나의 시퀀스
도식 6. 요청 하나의 시퀀스 — Jev 호출은 한 번, 이후 분기와 임계값은 전부 코드에 있다.
위 흐름에서 눈여겨볼 것은 Jev 호출이 한 번이라는 점입니다. 부서·불만 강도·환불 요청·정책 적용 여부를 한 왕복으로 묻고, 이후 분기는 전부 코드입니다. 임계값(0.5, 0.85 …)이 프롬프트가 아니라 코드에 있으므로 테스트할 수 있고 A/B 할 수 있습니다.
7.3 에이전트 루프에서의 자리
에이전트 한 턴은 보통 라우팅·검색 필요 판정·가드레일·결과 검증·완료 판정처럼 결정 다섯에 생성 하나입니다. 지금까지는 그 다섯을 직렬 생성으로 치렀습니다. 결정 하나가 수백 ms·$0.0004 라면 스캐폴딩을 아끼지 않게 됩니다. 이것이 TypeSafe 가 말하는 하네스 엔지니어링 논리이고, 멀티 에이전트 오케스트레이션 입문에서 다룬 오케스트레이터의 역할 중 '판단' 부분을 값싼 층으로 분리하는 것과 같은 방향입니다. 사람에게 넘기는 타이밍은 에이전트 핸드오프의 원칙 그대로, 신뢰도 바닥을 명시적 규칙으로 두는 것이 안전합니다.
7.4 검색 후 판단 (retrieve, then judge)
캐스케이드에서 Jev 가 하지 않는 단계가 하나 있고, 그것이 전체의 상한을 정합니다. Jev 는 state 밖의 세상을 모릅니다. 찾아볼 수 없습니다. 그리고 문서의 jaggedness 항목은 state 에 질문과 무관한 자료가 쌓일수록 정확도가 떨어진다고 명시합니다. 두 사실을 합치면 결론이 날카롭습니다 — state 를 조립하는 코드가 Jev 가 알 수 있는 세계를 결정합니다. 넓게 가져온 뒤 Noul 하나로 관련성을 거르고, 필요한 필드만 넣어 판단시키는 2층 구조가 RAG 앞단의 표준형이 됩니다. (패턴 5가지와 사례는 4편 — 활용 패턴.)
8. 벤치마크 읽기 — 67.8% 의 의미와 한계
TypeSafe 의 4개 워크플로 평가에서 Jev 는 67.8% 를 기록했습니다. 표만 보면 인상적입니다 — GPT-5.6 Terra(67.9%) 와 같은 수준이고, Claude Sonnet 5 도 정확히 67.8% 인데 케이스당 비용은 293배, 지연은 195배였다는 비교가 홍보 문구의 근거입니다. Opus 5(73.1%)·Sol(74.1%) 은 Jev 보다 높습니다.
모델 (TypeSafe 표)
점수
상대 비용
상대 지연
Sol
74.1%
—
—
Opus 5
73.1%
—
—
GPT-5.6 Terra
67.9%
—
—
Claude Sonnet 5
67.8%
293×
195×
Jev (jev-1.13.0)
67.8%
1×
1×
이 표를 논문 읽듯 읽으면 네 가지 각주가 붙습니다.
'점수'는 정확도가 아닙니다. 정답지가 없습니다. TypeSafe 는 GPT-6 Astra 와 Claude Fable 5.1 을 높은 사고 설정으로 돌려 합의 라벨을 만들고 그것과의 일치율을 잽니다. 두 모델이 결과표에 없는 이유이고, TypeSafe 도 이것이 OpenAI·Anthropic 계열에 유리한 편향이라고 인정합니다.
자체 실행입니다. 워크플로 설계·하네스·실행 모두 TypeSafe 가 했고, 독립 재현은 2026년 9월 말 기준 없습니다.
0% 형식 오류는 측정치가 아닙니다. 스키마 일치가 보장되니 넣은 값입니다. 비교 대상의 45.5% 는 단일 이상치(Haiku 4.5)이고 대부분은 0.58~13.2% 입니다.
가격은 움직일 수 있습니다.
그럼에도 이 표가 말하는 바는 남습니다. System 1 과제에 한정하면, 자기회귀 생성을 포기한 모델이 프론티어 LLM 과 비슷한 일치율을 두 자릿수 배 낮은 비용·지연으로 낸다는 것 — 적어도 TypeSafe 의 워크플로에서는 그랬습니다. 우리 데이터에서도 그런지는 우리가 재야 합니다.
9. 한계와 위협 모델 — jaggedness 페이지
사진 3. 빠른 System 1 과 느린 System 2 — 카너먼의 구분이 모델 부류의 이름이 됐다 (연출 사진).
TypeSafe 는 모델 버전마다 "이 모델이 못하는 것" 목록을 공개합니다. 이름이 jaggedness(들쭉날쭉함) 입니다. 출시 문서로는 이례적으로 정직하고, 도입 전에 읽으면 일주일을 아낍니다. 항목을 LLM 과 대비해 정리하면 다음과 같습니다.
실패 모드
Jev 에서의 증상
처방
LLM 과의 대비
문자 그대로 읽음
부정문·범위 한정어·암묵 조건을 액면대로 처리
"내가 진짜 뜻한 것"을 지시문에 쓴다
LLM 은 의도를 추론하지만, 그만큼 예측이 어렵다
계산 불가
개수를 못 세고 대상이 클수록 오차 증가
코드에서 순회, 항목마다 Noul 하나
LLM 도 산술은 약하나 도구 호출로 우회
날짜는 텍스트
선후·간격·기간 판정 불안정
추출은 Choice(열거 + '명시 안 됨'), 계산은 코드
동일
컨텍스트 부패
무관한 자료가 쌓이면 정확도 하락
먼저 거르고 필요한 필드만
LLM 도 동일하나 창이 더 크다
state 를 적대적으로 보지 않음
자기 분류를 유도하는 문장이 답을 움직임
사용자 입력이 state 에 들어가면 인젝션 테스트
LLM 의 프롬프트 인젝션과 같은 뿌리
모순된 기준
true=아니오 인 Noul 은 성능 저하
criteria 를 지시문의 연장으로
해당 없음
생성 불가
글·코드·요약·자유 추출 없음
후보를 만들어 고르게
LLM 의 본업
두 가지를 덧붙입니다.
운영상 — 버전 고정.jev-latest 는 지금 jev-1.13.0 이지만 새 릴리스가 나오면 옮겨 갑니다. 임계값을 튠해 둔 시스템에서 이것은 조용한 회귀입니다. 응답의 model 필드를 로깅하고, 클라이언트에 버전을 명시하는 것이 안전합니다.
개념상 — 캘리브레이션 ≠ 정답. 4절에서 말한 대로 캘리브레이션은 집계 성질입니다. 감사자에게 "왜 이 결정을 내렸는가"를 서술해야 하는 자리, 일회성의 복잡한 추론, 열린 답 공간은 Jev 의 자리가 아닙니다. 그 자리는 LLM 이 남습니다. (한계 전체 목록과 점검표는 5편 — 한계.)
10. 실무 도입 절차 — 첫 결정 하나부터
논문이라면 "향후 연구"에 해당할 부분을, 블로그이니 실행 절차로 씁니다.
10.1 접근
직접: typesafe.ai 대기자 명단 → console.typesafe.ai 에서 키 발급. Python typesafe-sdk, TypeScript @typesafe-ai/sdk. 두 SDK 모두 TYPESAFE_API_KEY 를 읽고 기본 모델은 jev-latest.
Vercel AI Gateway: 모델 ID typesafe-ai/jev, 같은 $0.042/1M. AI SDK 7(7.0.105+) 의 experimental_evaluate 가 이런 모델용 함수이고, OpenAI·Anthropic·Google 모델도 어댑터로 같은 질문에 답하게 할 수 있어 자기 라벨 데이터로 나란히 비교하기 좋습니다. 단 어댑터는 확률 분포를 돌려주지 않으므로 비교는 정확도·비용·지연에 한정됩니다.
10.2 절차
결정 하나를 고릅니다. 이미 코드나 LLM 이 하고 있고, 틀려도 값싼 것 — 티켓 1차 분류, 스팸 플래그, RAG 후보 문단 관련성 필터.
Playground 에서 state 와 질문 모양을 잡습니다. Choice 에 other, Noul 은 긍정문, Score 는 단계를 말로 서술.
기존 라벨 100~1,000건으로 돌려 신뢰도 구간별 정답률을 봅니다. 이것이 자기 데이터의 캘리브레이션 곡선입니다.
행동별 임계값을 정합니다. 읽기 전용은 낮게, 되돌리기 어려운 것은 높게, 바닥 미만은 사람.
그 결정 하나만 교체합니다. 파이프라인을 갈아엎지 않습니다.
버전을 고정하고 응답 model 을 로깅합니다. 다음 버전이 나오면 3단계를 다시 돕니다.
LLM 과 Jev 의 차이를 한 문장으로 줄이면 이렇습니다. LLM 은 문자열을 생성하는 System 2 이고, Jev 는 타입 있는 결정을 돌려주는 System 1 입니다. 다섯 축에서 본 차이는 전부 이 한 문장의 결과입니다.
축
LLM
Jev
① 출력 계약
문자열 (스키마는 사후)
확률 분포 + 신뢰도
② 생성 원리
자기회귀
병렬 샘플링
③ 훈련 목표
RLHF — 선호
RLCD — 캘리브레이션
④ 비용·지연
입력+출력, 출력 길이 비례
입력만, 질문 수 무관
⑤ 아키텍처
생성·추론·서술 층
분류·라우팅·가드레일 층
그래서 올바른 질문은 "어느 쪽이 더 좋은가"가 아니라 "우리 시스템의 어느 호출이 System 1 이었는가" 입니다. 그 호출들을 찾아 값싼 층으로 내리고, 남은 생성 호출은 그 자격이 있을 때만 부르는 것 — 이것이 2026년 9월 이후 AI 시스템 설계에서 새로 생긴 선택지입니다.
Jev 가 그 선택지의 최종 형태일지는 모릅니다. 인터페이스 패턴만 오픈 모델의 로짓으로 재현한 프로젝트(openjev)가 이미 있고, 다른 연구소가 같은 부류의 모델을 낼 수도 있습니다. 하지만 "결정은 문자열이 아니라 타입으로 돌려받는다" 는 계약 자체는, 한 번 써 보면 되돌리기 어려운 종류의 것입니다.
다음 행동 — 팀의 AI 호출 목록을 한 장에 정리해 보세요. 어떤 호출이 결정이고 어떤 호출이 생성인지, 각각의 비용·지연·실패 모드를 표로. Linkme 보드에 의사결정 표를 만들고 팀과 공유하면 이 글의 5축 표가 그대로 출발점이 됩니다. AI 가 읽는 문서도 낡는다는 점은 AX 콘텐츠 갱신 주기에서 다뤘듯 이 글도 마찬가지입니다 — 가격·버전은 공식 문서에서 다시 확인하세요.